Usar el modelo más potente para todo también es elegir mal. Es una intuición muy extendida: si existe una versión máxima, lo razonable parece abrir siempre esa y olvidarse del resto. Pero cada modelo cuesta distinto, responde a velocidades distintas y está pensado para un tipo de encargo, y aplicar la máxima capacidad a una tarea sencilla es pagar más y esperar más por un resultado que apenas cambia. La decisión sensata empieza antes de abrir ChatGPT o Claude, preguntándose qué hay que resolver.
La regla de partida es sencilla. Para resúmenes breves y clasificación, lo que importa es la rapidez. Para documentos y trabajo diario, el equilibrio entre capacidad y coste. Y para programación, investigación y tareas con muchos pasos, la capacidad de completar el encargo de principio a fin. Con esas tres categorías en la cabeza, el catálogo de ambas plataformas deja de parecer un laberinto de nombres.
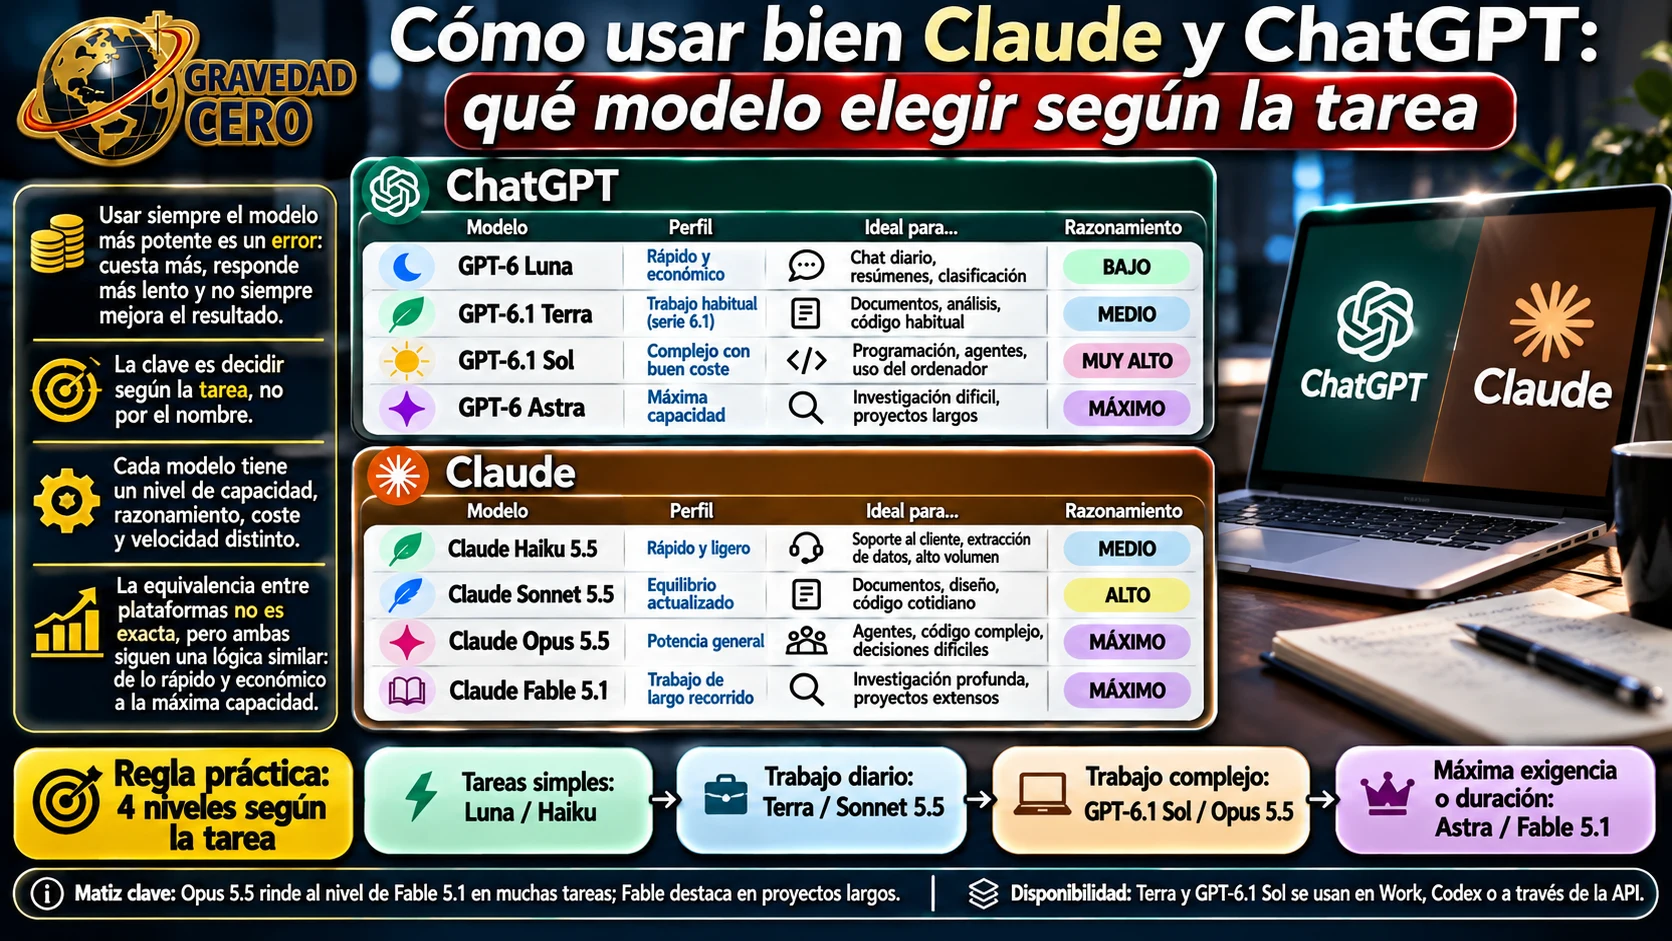
En ChatGPT, la escalera empieza con GPT-6 Luna, el modelo rápido y económico, con un nivel de razonamiento bajo y pensado para el chat diario, los resúmenes y la clasificación. Un escalón por encima está GPT-6.1 Terra, el de trabajo habitual dentro de la serie 6.1, con razonamiento medio y buen encaje en documentos, análisis y código corriente. GPT-6.1 Sol es el que se reserva para lo complejo con buen coste: programación, agentes y uso del ordenador, con un razonamiento muy alto. Y en lo más alto aparece GPT-6 Astra, la máxima capacidad, con el razonamiento al máximo y orientada a investigaciones difíciles y proyectos largos.
Claude sigue una lógica paralela. Claude Haiku 5.5 es el rápido y ligero, con razonamiento medio, y su sitio está en el soporte al cliente, la extracción de datos y los trabajos de alto volumen, donde se repite la misma tarea miles de veces y cada segundo y cada céntimo cuentan. Claude Sonnet 5.5 es el equilibrio actualizado, con razonamiento alto, y cubre documentos, diseño y código cotidiano. Claude Opus 5.5 ofrece la potencia general, con razonamiento máximo, para agentes, código complejo y decisiones difíciles. Y Claude Fable 5.1 es el de trabajo de largo recorrido, también con razonamiento máximo, pensado para investigación profunda y proyectos extensos.
Hay un matiz importante en cómo se comparan los dos escalones superiores de Claude. Opus 5.5 rinde al nivel de Fable 5.1 en muchas tareas, y Fable destaca sobre todo en proyectos largos. Es decir, la diferencia no se nota tanto en la dificultad de cada problema como en la duración y el tamaño del encargo. Para una decisión compleja o un código exigente, Opus puede ser suficiente. Para un trabajo que se prolonga durante horas o que exige mantener el hilo a lo largo de muchos pasos, es donde Fable marca la diferencia.
Todo esto se resume en una regla práctica de cuatro peldaños. Para tareas simples, Luna en ChatGPT o Haiku en Claude. Para el trabajo diario, Terra o Sonnet 5.5. Para el trabajo complejo, GPT-6.1 Sol u Opus 5.5. Y para la máxima exigencia o duración, Astra o Fable 5.1. La equivalencia entre plataformas no es exacta, pero sirve como mapa: cada escalón sube en capacidad, y también en coste y en tiempo de respuesta.
Conviene fijarse también en el nivel de razonamiento, que no coincide siempre con el escalón. Luna trabaja con un razonamiento bajo y Terra con uno medio, igual que Haiku, mientras que Sonnet 5.5 sube a alto y Sol a muy alto. Opus, Fable y Astra llegan al máximo. Ese nivel es orientativo y cambia según la tarea, pero deja claro que, en los modelos intermedios, parte de la diferencia está en cuánto «piensa» antes de responder, y que más razonamiento no siempre equivale a una respuesta mejor.
Hay un último factor práctico, y es la disponibilidad. Según el plan que se tenga contratado, no todos los modelos están al alcance: Terra y GPT-6.1 Sol se usan en Work, en Codex o a través de la API.